Об авторе
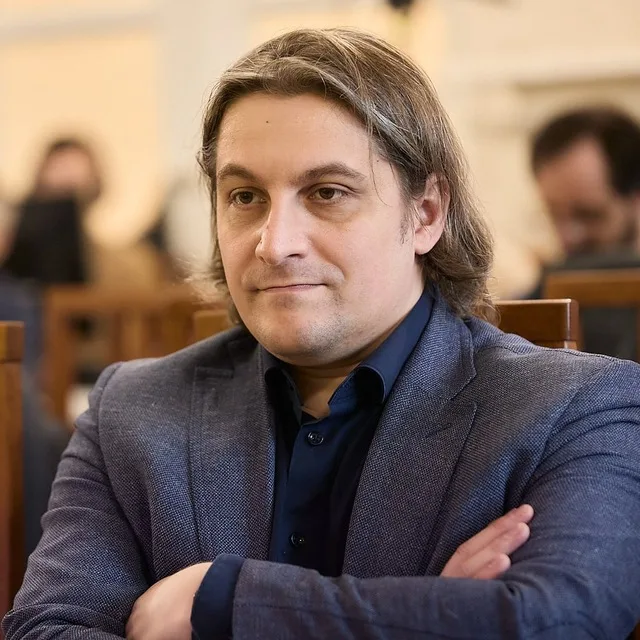
Иван Бегтин занимается открытыми данными: собирает и разбирает данные государства и науки, делает сервисы, которые помогают их найти, и пишет о том, как их публикуют. Он основатель и технический директор поисковика по наборам данных Dateno, основатель и директор АНО «Информационная культура» (Инфокультура) и сооснователь проекта «Открытые данные Армении» (opendata.am).
Открытостью государства и открытыми данными он занимается с 2009 года, каталогами данных — с 2010-го. Эта книга выросла из той же работы. Реестр каталогов, по которому посчитаны её цифры, он начал для своих проектов, а многие примеры и подсчёты в главах взяты из его заметок.
Путь
В ИТ Иван Бегтин работает с 1999 года. Начинал с администрирования серверов Unix, потом был разработчиком и руководил лабораторией интеллектуального анализа данных.
В 2009 году он запустил проект «Государство и его информация» (opengovdata.ru) — новости и базу знаний об открытых государственных данных в России. Проект проработал до 2015 года. Тогда же он начал сохранять копии сайтов органов власти, которые закрывались или менялись.
В 2010 году он стал одним из учредителей конкурса Apps4Russia, где разработчики делали приложения на государственных данных. В марте 2012 года основатели конкурса создали АНО «Информационная культура», и с тех пор Иван Бегтин ею руководит. Среди проектов Инфокультуры — открытая база государственных контрактов «Госзатраты» (clearspending.ru) и ежегодный День открытых данных в Москве.
В 2019–2021 годах он руководил проектным направлением «Открытые данные» в Счётной палате России. Команда из шести человек за четыре с половиной месяца сделала там портал «Госрасходы» (spending.gov.ru). Его запустили в ноябре 2019 года: на портале были контракты, субсидии и расходы на национальные проекты, а сами сведения отдавались открытыми данными и через API.
Ещё одна давняя тема автора — понятный язык в текстах государства. В 2014 году он адаптировал к русскому языку формулы удобочитаемости, которыми в англоязычных странах проверяют официальные тексты. Эта книга написана по тем же правилам: простые слова и сначала вывод.
Каталоги данных
Первым каталогом стал «Хаб открытых данных» hubofdata.ru на CKAN. Иван Бегтин сделал его в 2010–2011 годах под маркой OpenGovData, и он появился раньше государственных порталов открытых данных в России (об этом — в короткой истории каталогов). Позже Инфокультура запустила на той же платформе портал данных для некоммерческих организаций «Данные НКО» ngodata.ru. Оба общественных портала книга вспоминает в главе об экспорте метаданных: в ноябре 2024 года Google Dataset Search по русским запросам выдавал их наборы на первых местах, потому что на их страницах есть разметка schema.org для поисковиков.
Через десять лет каталогов стало так много, что понадобились каталоги каталогов. В ноябре 2021 года Инфокультура запустила перечень каталогов данных России datacatalogs.ru: при запуске в нём было 245 записей. В 2023 году работа вышла за пределы одной страны. В проекте Common Data Index начался открытый реестр каталогов всего мира, в апреле 2023 года в нём было 1,7 тысячи записей. Теперь это реестр dataportals-registry: в выпуске 1.27.0 от 15 октября 2026 года описаны 43 614 каталогов и 790 платформ.
В марте 2024 года на основе реестра заработал поисковик Dateno. Он узнаёт из записи реестра платформу каталога и адреса его API и по ним забирает описания наборов. На 16 октября 2026 года в Dateno 22 миллиона наборов из 5 236 источников. Почему одни каталоги собрать легко, а до других сборщик не доходит, разобрано в главах «Поисковики и агрегаторы» и «Находимость».
Сохранение данных и инструменты
С 2017 года Инфокультура ведёт Национальный цифровой архив (ruarxive.org). Он сохраняет сайты и данные, которые могут исчезнуть, прежде всего государственные. В 2022 году архив провёл кампанию архивации порталов открытых данных, в 2025 году сохранил сайты Росстата и систему статистики ЕМИСС. Как устроена такая работа, рассказано в главе «Архивация и спасение каталогов».
Для своей работы автор пишет инструменты с открытым кодом. undatum обрабатывает файлы данных из командной строки: CSV, NDJSON, XML и другие форматы. metacrafter определяет, что лежит в колонках таблицы: идентификаторы, коды, персональные данные. apibackuper сохраняет данные, которые отдаются только постранично через API. Он упоминается в главах об API и массовой выгрузке и об архивации.
Автор и источники книги
Книга и база знаний о каталогах данных создаются при поддержке Dateno. Реестр каталогов и Dateno — проекты автора, поэтому книга ссылается на них чаще, чем на чужие. Это можно проверить. Цифры реестра получены открытыми запросами, они собраны в приложении «Как работать с реестром» и на выпуске 1.27.0 дают те же числа. Версии программ и возможности платформ сверены с документацией самих платформ, а не с реестром.
Заметки автора из Telegram-канала и рассылки в разделах «Источники» подписаны «И. Бегтин», у каждой стоит дата. Это наблюдения на день заметки. Если цифра с тех пор могла измениться, сверяйтесь с датой.
Где читать и как связаться
- Telegram-канал «Ivan Begtin» — открытые данные, инженерия данных, государство, приватность и сохранение цифрового наследия. На 16 октября 2026 года у канала 9 093 подписчика.
- Рассылка begtin.substack.com — длинные тексты о цифровом, открытом и сохраняемом государстве.
- Код — github.com/ivbeg, профиль в LinkedIn — linkedin.com/in/ivbeg, ORCID — 0000-0002-9084-9643.
- Личный сайт — begtin.tech: книги, проекты и тексты.
- Почта — ivan@begtin.tech.
Замечания и исправления к книге можно прислать на почту или в Telegram.
Источники
- Профили автора: GitHub — проекты Dateno, APICrafter, «Открытые данные Армении», Инфокультура; LinkedIn — «Государство и его информация» (2009–2015), сохранение сайтов органов власти (с 2009 года), Apps4Russia (с 2010 года), Национальный цифровой архив (с 2017 года); описание Telegram-канала — темы канала и число подписчиков на 16 октября 2026 года; Facebook — сооснователь Open Data Armenia, Счётная палата в 2019–2021 годах
- TAdviser, Бегтин Иван Викторович — работа в ИТ с 1999 года, лаборатория интеллектуального анализа данных, соучредитель Apps4Russia
- «Данные НКО», карточка АНО «Информационная культура» — организацию создали в марте 2012 года основатели конкурса Apps4Russia
- TAdviser, Госрасходы — запуск 18 ноября 2019 года, разработка с июня по ноябрь 2019 года силами шести человек, открытые данные и API; Росконгресс, карточка спикера — руководитель проектного направления «Открытые данные» Счётной палаты
- И. Бегтин, Что такое «Понятный русский язык» с точки зрения технологий, Хабр, 2 октября 2014 — формулы удобочитаемости для русского языка
- И. Бегтин, Telegram: Хаб открытых данных, созданный в 2010–2011 годах под маркой OpenGovData, 14.04.2021; запуск datacatalogs.ru, 03.11.2021; Common Data Index и реестр каталогов, 10.04.2023; запуск Dateno, 13.03.2024
- Реестр каталогов данных dataportals-registry, выпуск 1.27.0 от 15 октября 2026 года; Dateno на 16 октября 2026 года
- Национальный цифровой архив; «Открытые данные Армении»