Каталоги данных
Как устроены порталы открытых данных, геопорталы и репозитории — и как выбрать свой.
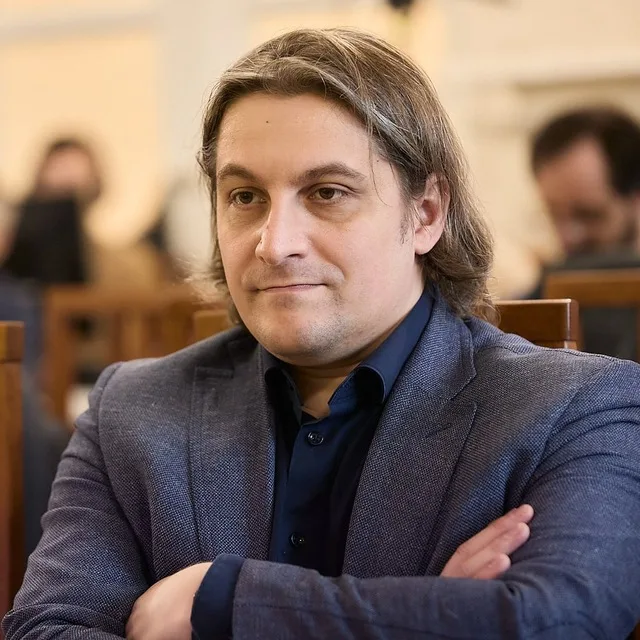
Автор — Иван Бегтин, основатель и директор АНО «Информационная культура», основатель и технический директор поисковика по наборам данных Dateno. Открытыми данными занимается с 2009 года, каталогами — с 2010-го: от общественного «Хаба открытых данных» до реестра каталогов всего мира, по которому посчитаны цифры этой книги. Подробнее — в главе «Об авторе».
Книга и база знаний о каталогах данных создаются при поддержке Dateno — поисковой системы по наборам данных. Dateno собирает описания наборов из тысяч каталогов по всему миру: порталов открытых данных, геопорталов, научных репозиториев и статистических служб — и ищет по ним в одном месте. На 16 октября 2026 года в нём 22 миллиона наборов из 5 236 источников.
Редакция октября 2026 года. Текст доступен по лицензии CC BY 4.0.
Скачать книгу в PDF: на русском · in English. Английская версия сайта — в переключателе языков в меню.
Каталог данных — сервис, который описывает наборы данных и помогает их найти, понять и получить. Эта книга — о публичных каталогах: порталах открытых данных, геопорталах, научных репозиториях, каталогах статистики и наборов для машинного обучения. Она объясняет, какие каталоги бывают и что они умеют, как выбрать функции и платформу и обосновать выбор, как публиковать данные — на портале или без него.
Корпоративные каталоги, которые описывают данные внутри компании (Collibra, Alation, DataHub), в книге упоминаются только для сравнения.
Если вы ищете не каталог, а сами данные, начните с поиска в Dateno. Как он связан с цифрами книги — в разделе «Откуда цифры».
С чего начать
Книгу не нужно читать подряд. Выберите свою задачу: под ней 4–6 глав в порядке чтения и то, что будет у вас в конце. Если ни одна задача не подходит, пройдите маршрутную карту: восемь вопросов, около пяти минут.
Поручили запустить портал открытых данных — орган власти, регион, город · 6 глав, около 1 ч 15 мин
- Маршрутная карта выбора — первый ориентир по типу каталога и платформе.
- Типовые сценарии — найдите свою строку: центральный орган, регион или муниципалитет.
- Когда портал не нужен — может быть, задачу уже закрывает региональный или национальный портал.
- Принципы выбора набора функций — список функций из задач, а не из рекламы.
- Чек-лист требований — что положить в техническое задание.
- Как обосновать решение — карточка решения для руководителя и для следующего сотрудника.
В конце у вас: ответ, нужен ли свой портал, список функций для технического задания и карточка решения.
Выбрать платформу или написать техническое задание · 6 глав, около 1 ч 45 мин
- Карта возможностей — какие возможности бывают и что типично для вашего типа каталога.
- Принципы выбора набора функций — у каждой функции пять пометок: чья задача, насколько обязательна, почему, как проверить, когда пересмотреть.
- От функций к платформе — как превратить список функций в короткий список платформ.
- Экосистемы расширений — как проверить расширение до того, как платформа попадёт в список.
- Карточки платформ — что у каждой платформы в ядре, что в расширениях, какие ограничения.
- Чек-лист требований.
В конце у вас: короткий список платформ с пометками «в ядре», «в расширении», «нет» и требования для технического задания.
Опубликовать данные к статье, нужен DOI · 5 глав, около 1 ч 35 мин
- Научные репозитории данных — Zenodo, профильный или университетский репозиторий.
- Постоянные идентификаторы, DOI и версии — чем DOI версии отличается от общего DOI.
- Экспорт цитирования — как набор будут цитировать и зачем файл
CITATION.cff. - Лицензии и условия доступа — какую лицензию поставить и что она разрешает.
- Как сделать публикацию находимой — чтобы набор нашли поисковики и агрегаторы.
В конце у вас: выбранный репозиторий, DOI, лицензия и файл цитирования.
Опубликовать несколько наборов без своего портала · 4 главы, около 50 мин
- Когда портал не нужен — пять вопросов до установки.
- Статические сайты или Git-репозитории — выберите один способ.
- Как сделать публикацию находимой — страница набора, файл описаний и ссылки из чужих каталогов.
- Чек-лист «Минимум публикации без портала» и шаблоны файлов — README,
datapackage.json,CITATION.cff, разметка schema.org.
В конце у вас: страница или репозиторий с описаниями наборов, которые находят поисковики и агрегаторы.
Собирать описания из многих каталогов — разработчик поисковика или агрегатора · 5 глав, около 1 ч 50 мин
- Поисковики и агрегаторы данных — чем поисковик отличается от агрегатора.
- Экспорт метаданных — DCAT, schema.org и что на деле отдают платформы.
- API и массовая выгрузка — полная выгрузка против поискового API.
- Федерации и агрегация — как собирают описания и где теряются записи.
- Стандарты метаданных — какой язык описаний читает каждый адресат.
В конце у вас: какие протоколы и форматы забирать у каждого типа каталогов и какие потери ждать.
Статистическая служба: показатели и микроданные · 5 глав, около 2 ч
- Разобранный пример статистической службы — почему это два каталога, а не один.
- Каталоги показателей — временные ряды, SDMX, PxWeb и .Stat Suite.
- Каталоги микроданных — обезличенные записи, DDI, NADA и доступ по запросу.
- Карточки платформ — PxWeb, .Stat Suite и NADA.
- Чек-листы каталога показателей и каталога микроданных.
В конце у вас: два каталога с разными стандартами и короткий список платформ для каждого.
Проверить и улучшить свой каталог · 4 главы, около 45 мин
- Уровни качества — какой уровень трогает оценка и кто за него отвечает.
- Самоаудит каталога — как пройти свой каталог за один раз.
- Антипаттерны — типичные сбои и откуда они берутся.
- Хорошие практики — шесть вещей, без которых набор нельзя найти или использовать.
Для проверки на живом сайте — чек-лист проверки портала.
В конце у вас: список проблем по уровням качества и порядок починки.
Главное в девяти тезисах
- Каталог — это описания, а не склад файлов. Без описания ссылка на файл — ещё не каталог. → Что такое каталог данных
- Тип каталога задаёт то, что в нём публикуют. От типа зависят стандарт описания и круг подходящих платформ. → Как классифицировать каталоги
- Свой портал нужен не всегда. Пока наборов и публикаторов немного, данные публикуют в чужом каталоге, на своём сайте, в репозитории или на общем хабе. → Когда портал не нужен
- Функции выбирают по задачам, а не по рекламе платформы и не по чужому техническому заданию. → Принципы выбора набора функций
- У каждой функции есть адрес: ядро платформы, названное расширение или нигде. Если обязательная функция держится на расширении, которое не проверяют на вашей версии ядра, платформу вычёркивают. → Экосистемы расширений
- Способ создания выбирают раньше марки. Платформа бесполезна, если её некому обновлять. → Свои силы, свободное ПО или облачный сервис
- Решение записывают. Карточка решения объясняет следующему сотруднику, какое обязательство закрывает платформа и когда выбор пересматривать. → Как обосновать решение
- Набор опубликован, когда посторонний может им воспользоваться: находит карточку, открывает файл, читает лицензию и знает, кто отвечает за данные. → Процесс публикации
- У качества четыре уровня. Высокий балл на одном не исправляет остальные. → Уровни качества
Содержание
Время — оценка для чтения подряд, без примеров кода. Всего около 17 часов.
- I. Что такое каталог данных · 4 главы, 30 мин — определение, устройство каталога, мир каталогов в цифрах.
- II. Какие данные публикуют · 2 главы, 25 мин — что публикуют, единицы публикации и форматы.
- III. Типы каталогов · 11 глав, 4 ч 30 мин — порталы открытых данных, геопорталы, научные репозитории, статистика, ML, метаданные, агрегаторы и гибриды.
- IV. Возможности каталогов · 10 глав, 3 ч 40 мин — экспорт метаданных, API, хранилище, DOI, цитирование, доступ и роли.
- V. Платформы и расширения · 4 главы, 1 ч 10 мин — классы программ, ядро и расширения, CKAN, карточки платформ.
- VI. Как выбрать каталог · 8 глав, 1 ч 40 мин — маршрутная карта, выбор функций и платформы, обоснование, сценарии и примеры.
- VII. Как публикуют данные · 5 глав, 1 ч 10 мин — процесс, стандарты метаданных, федерации, лицензии, находимость.
- VIII. Публикация без портала · 5 глав, 1 ч — статические сайты, Git, облачные хранилища и хабы.
- IX. Практики · 4 главы, 50 мин — хорошие практики, антипаттерны, жизненный цикл, архивация.
- X. Качество каталогов · 4 главы, 50 мин — уровни, метрики, методики и рейтинги, самоаудит.
- XI. Тренды · 2 главы, 40 мин — ИИ, пространства данных и регулирование; что уже умеют передовые каталоги.
- Приложения · справочник — глоссарий, работа с реестром, таблицы платформ, чек-листы, литература.
- Об авторе — кто написал книгу и как его проекты связаны с её цифрами.
Как устроены главы
- Сначала вывод. Глава начинается с главного вывода, подробности и примеры — ниже.
- Ядро, расширение или нет. В главах о возможностях и в карточках платформ для каждой функции сказано, где она живёт: в самой платформе, в отдельном модуле со своим автором и выпусками или нигде.
- Карточка решения — одна-две страницы о выборе: контекст, варианты, критерии, решение, почему, когда пересмотреть. Шаблон — в главе «Как обосновать решение».
- Даты у фактов. Версии программ и состояние сайтов меняются, поэтому факты записаны «на октябрь 2026 года». Последний раздел каждой главы — «Источники».
- Незнакомое слово ищите в глоссарии.
Готовые материалы для работы: чек-листы, сравнительные таблицы платформ, шаблоны файлов и запросы к реестру каталогов.
Откуда цифры
Цифры о числе каталогов и платформ посчитаны по открытому реестру каталогов данных dataportals-registry, выпуск 1.27.0 от 15 октября 2026 года. В нём описаны 43 614 каталогов и 790 платформ. Основные запросы, которыми получены цифры книги, собраны в приложении о реестре: на этом выпуске они дают те же числа. Реестр обновляется каждые несколько дней, на более новых выпусках числа будут другими.
Реестр изначально создавался для поисковика по наборам данных Dateno, и Dateno до сих пор индексирует порталы по их описаниям в реестре: из записи он узнаёт платформу каталога и адреса API, а по ним — каким сборщиком забирать наборы. На 16 октября 2026 года в Dateno 22 миллиона наборов из 5 236 источников. Почему одни каталоги собрать легко, а до других сборщик не доходит, разобрано в главах «Поисковики и агрегаторы» и «Находимость».
Версии программ и возможности платформ проверены по первоисточникам в октябре 2026 года.
Об издании
Автор — Иван Бегтин. Редакция — октябрь 2026 года.
Поддержка. Книга и база знаний создаются при поддержке проекта Dateno, поисковой системы по наборам данных. Автор — основатель и технический директор Dateno; как это сказывается на источниках книги, объяснено в главе «Об авторе».
Лицензия. Текст распространяется по лицензии Creative Commons «Атрибуция» 4.0 Международная (CC BY 4.0). Его можно копировать, переводить и использовать в своих материалах, в том числе коммерческих, если указать автора и дать ссылку на книгу.
Как цитировать.
Бегтин И. Каталоги данных: как устроены порталы открытых данных, геопорталы и репозитории — и как выбрать свой. — Редакция октября 2026 г. — URL: https://datacatalogs.begtin.tech/ (дата обращения: ДД.ММ.ГГГГ).